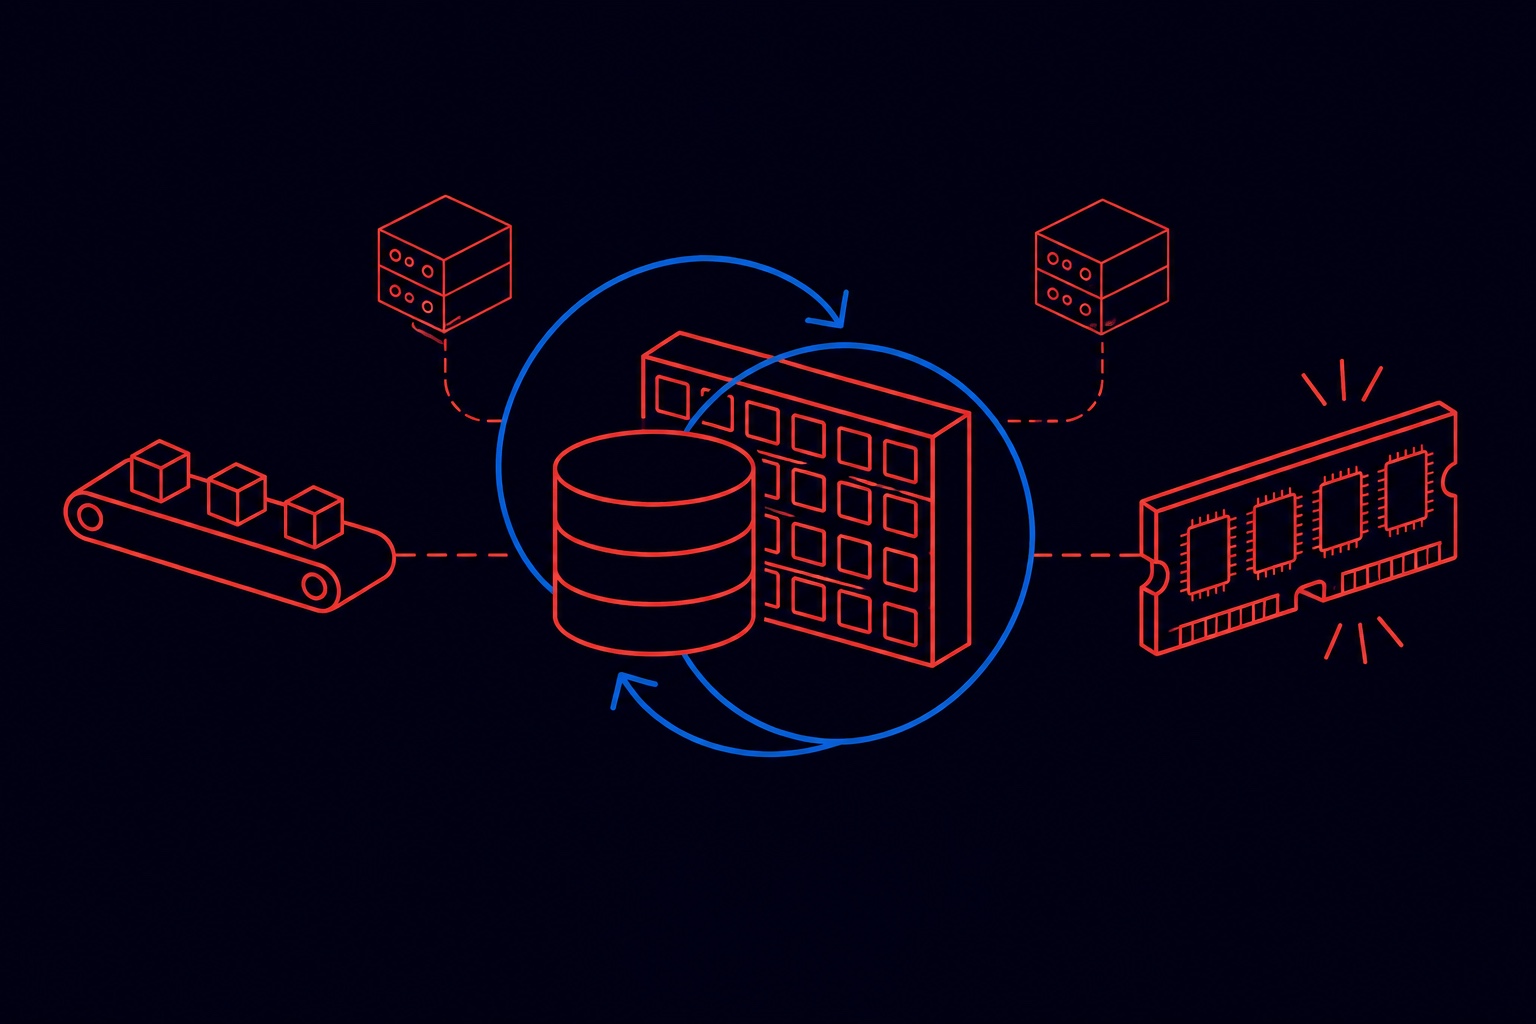
После каждой загрузки остатков интернет-магазин запускал переиндексацию практически всего каталога. Процесс потреблял до 10 ГиБ оперативной памяти, а при повторной синхронизации мог стартовать снова, не дожидаясь завершения предыдущего. Мы разобрали цепочку обновлений и выяснили: проблема была не в недостатке серверных ресурсов, а в логике обработки изменений.
Содержание
- Симптомы: переиндексация после каждой загрузки остатков
- Как мы диагностировали нагрузку на MySQL
- Что оказалось причиной: каскадное обновление каталога
- Что мы изменили в логике обновления
- Результат: меньше лишних операций при синхронизации
- Выводы: почему такие проблемы возникают
- Что рекомендуем владельцам больших каталогов
- Чего делать не стоит
- Итог: сначала разобраться в логике, потом масштабировать сервер
Симптомы: переиндексация после каждой загрузки остатков
В одном из интернет-магазинов с большим каталогом товаров возникла проблема с нагрузкой на MySQL. После каждой синхронизации остатков из учётной системы запускалась масштабная переиндексация каталога.
Сама по себе индексация необходима: поисковые механизмы должны учитывать актуальные данные о товарах. Но в данном случае даже обновление остатков приводило к обработке практически всего каталога, независимо от того, сколько записей действительно изменилось.
Мы наблюдали несколько характерных симптомов:
- После загрузки остатков резко увеличивалось потребление оперативной памяти.
- Во время переиндексации процесс мог использовать до 10 ГиБ RAM.
- Повторная загрузка запускала новую обработку, даже если предыдущая ещё не завершилась.
- Несколько одновременно работающих процессов создавали дополнительную нагрузку на сервер.
Возникал эффект снежного кома: очередная синхронизация добавляла работу системе, которая ещё не справилась с предыдущей.
Увеличение оперативной памяти или мощности сервера могло бы временно смягчить проблему. Но если каждое обновление остатков запускает обработку всего каталога, дополнительные ресурсы не устраняют причину.
Как мы диагностировали нагрузку на MySQL
Первым делом мы перешли от общего описания «сервер тормозит» к измерениям.
Нужно было ответить на три вопроса: какие операции потребляют ресурсы, почему они запускаются и могут ли выполняться одновременно.
1. Сняли показатели потребления ресурсов
Мы проверили нагрузку на сервер во время синхронизации и последующей переиндексации. Отдельное внимание уделили памяти: потребление доходило до 10 ГиБ.
При диагностике подобных проблем важно учитывать не только сам MySQL, но и прикладные процессы, выполняющие обновление каталога. Если индексация реализована на уровне приложения, значительная часть памяти может потребляться вне процесса базы данных.
2. Проанализировали slow query log
Slow query log — журнал медленных запросов MySQL. Он позволяет выявить SQL-операции, которые выполняются слишком долго, обрабатывают большое количество строк или создают дополнительную нагрузку.
Для диагностики можно временно включить запись запросов, выполняющихся дольше одной секунды:
SET GLOBAL log_output = 'FILE';
SET GLOBAL long_query_time = 1;
SET GLOBAL slow_query_log = ON;
Это пример диагностической настройки, а не универсальная конфигурация для production. Порог подбирается под конкретную систему. Перед изменением параметров нужно проверить текущие значения, права доступа, объём логирования и наличие свободного места на диске.
При анализе журнала нас интересовали продолжительность запросов, количество просмотренных строк и повторяемость тяжёлых операций после каждой загрузки остатков.
3. Проследили последовательность обновлений
Анализ запросов и логики обмена позволил установить связь между синхронизацией остатков, обновлением привязок товаров к магазинам и запуском переиндексации.
Именно эта последовательность оказалась ключевой. Проблема заключалась не в одном изолированном SQL-запросе, а в том, какие дополнительные действия инициировало обновление данных.
Что оказалось причиной: каскадное обновление каталога
При загрузке новых остатков система не ограничивалась изменением количества доступного товара.
В той же цепочке выполнялось обновление привязок товаров к магазинам. Эта операция запускала механизм перестроения поисковых индексов.
В результате относительно локальные изменения приводили к обработке практически всего каталога.
Упрощённо цепочка выглядела так:
- Система получает новые остатки из учётной системы.
- Обновляет данные о наличии товаров.
- Запускает обновление привязок товаров к магазинам.
- Механизм индексации воспринимает изменения как основание для масштабного пересчёта.
- При следующей загрузке аналогичная цепочка может запуститься повторно.
Здесь важно различать два механизма.
FULLTEXT-индексы MySQL используются для полнотекстового поиска по текстовым полям. Их обновление и обслуживание зависит от механизма хранения и выполняемых SQL-операций.
Прикладной поисковый или фасетный индекс может строиться отдельным кодом интернет-магазина. Он собирает сведения из разных таблиц — например, о товарах, наличии, магазинах и характеристиках.
В обоих случаях ошибка в логике обновления способна привести к избыточной работе. Но способы оптимизации будут различаться.
В нашем случае существенным оказался сам факт ненужной массовой переиндексации после обновления остатков и связей товаров с магазинами.
Что мы изменили в логике обновления
Решение строилось вокруг одного принципа: изменение части каталога не должно автоматически запускать обработку всего каталога.
Разделили обновление остатков и привязок
Мы разделили операции изменения остатков и обновления привязок товаров к магазинам.
Это позволило устранить ненужную взаимозависимость, при которой обновление одного набора данных инициировало дополнительные операции над другим.
Если у товара изменилось количество на складе, это ещё не означает, что необходимо повторно перестраивать все связанные данные для остальных товаров.
Объединили сохранение данных в один проход
Ранее связанные операции могли приводить к повторным сохранениям и дополнительным вызовам индексации.
Мы переработали обработчик так, чтобы необходимые изменения сохранялись за один проход, без повторного выполнения одинаковых действий.
Для больших каталогов это особенно важно. Даже относительно недорогая операция становится проблемой, если она многократно вызывается внутри массового обновления.
При этом единый проход не обязательно означает одну транзакцию на весь каталог. Большие загрузки можно обрабатывать пачками с контролируемыми транзакциями. Главное — исключить повторные действия и обеспечить согласованное завершение обмена.
Ограничили переиндексацию изменёнными записями
Следующим изменением стала логика запуска индексации.
Вместо обработки практически всего каталога механизм должен затрагивать только записи, данные которых действительно изменились и влияют на индекс.
Например, если после синхронизации изменились остатки отдельных товаров, нет необходимости пересчитывать поисковые данные остальных позиций, если они от этих изменений не зависят.
Для прикладного индекса это может означать передачу списка изменённых идентификаторов. Для FULLTEXT MySQL — исключение ненужных обновлений индексируемых полей и полных операций перестроения.
Это не одно и то же технически, но цель общая: сократить объём лишней работы.
Добавили контроль времени и памяти
Параллельно мы настроили мониторинг процесса индексации.
Система должна сигнализировать, если продолжительность выполнения или потребление памяти превышают заданные пороги.
Такой контроль помогает заметить проблему до того, как несколько тяжёлых операций начнут конкурировать за ресурсы.
Результат: меньше лишних операций при синхронизации
Главным результатом стала переработка самой причины нагрузки.
Мы разделили обновление остатков и привязок, устранили повторное сохранение данных, изменили механизм индексации и добавили контроль ресурсоёмких операций.
Вместо автоматической обработки практически всего каталога после каждой синхронизации логика ориентирована на реально изменённые записи.
Это сокращает объём ненужной работы и снижает риск перегрузки сервера из-за массовой переиндексации.
Выводы: почему такие проблемы возникают
Из этого случая можно сделать несколько практических выводов.
1. Массовая переиндексация опаснее, чем кажется
Если магазин содержит большое количество товаров, даже одна полная обработка каталога может заметно нагружать сервер.
Если она запускается после каждой загрузки остатков, ресурсная нагрузка повторяется регулярно.
2. Память — показатель проблемы, а не готовый диагноз
Потребление около 10 ГиБ может быть связано с временными таблицами, сортировками, крупными промежуточными наборами данных или памятью прикладного обработчика.
Но сама цифра не доказывает конкретную причину. Нужны журнал запросов, профилирование и замеры ресурсов отдельных процессов.
3. Причину нужно искать в последовательности операций
Самый медленный SQL-запрос не обязательно является корнем проблемы.
Иногда достаточно изменить порядок обновлений или исключить ненужное сохранение связанных данных, чтобы убрать целую цепочку тяжёлых запросов.
4. Параллельный запуск может уничтожить эффект оптимизации
Даже если отдельная индексация стала быстрее, её одновременный запуск в нескольких экземплярах способен снова привести к перегрузке.
Поэтому важно не только ускорять обработчик, но и контролировать число одновременно выполняемых заданий.
Что рекомендуем владельцам больших каталогов
1. Управляйте запуском индексации
Если архитектура позволяет, не запускайте полную прикладную переиндексацию после каждого изменения в процессе массовой загрузки.
Сначала завершите необходимые изменения данных, затем выполните одну согласованную обработку индекса.
Это не означает отключение внутренних механизмов поддержания индексов MySQL. Речь прежде всего об управляемых заданиях приложения, которые можно отложить или объединить.
2. Используйте инкрементальное обновление
Для прикладных поисковых и фасетных индексов стоит предусмотреть обработку только изменённых товаров.
Если такой возможности нет, каталог можно разделить на логические сегменты и пересчитывать только затронутые части.
Важно учитывать зависимости. Если изменение одного товара влияет на агрегированные показатели категории, пересчитывать нужно и соответствующие агрегаты.
3. Контролируйте активные запросы
Для первичной диагностики можно использовать список активных операций MySQL:
SELECT
    ID,
    USER,
    DB,
    COMMAND,
    TIME,
    STATE,
    LEFT(INFO, 200) AS QUERY_TEXT
FROM performance_schema.processlist
WHERE COMMAND <> 'Sleep'
ORDER BY TIME DESC
LIMIT 20;
Запрос показывает выполняющиеся операции и время нахождения потока в текущем состоянии.
Это полезная отправная точка при поиске длительных SQL-запросов. Однако она не заменяет метрики прикладного обработчика и не показывает непосредственно потребление памяти каждым заданием.
В старых конфигурациях MySQL аналогичные сведения можно получить через SHOW FULL PROCESSLIST или INFORMATION_SCHEMA.PROCESSLIST.
4. Отслеживайте потребление памяти
При включённом Performance Schema и необходимых инструментах учёта памяти можно исследовать потребление по потокам:
SELECT
    THREAD_ID,
    SUM(CURRENT_NUMBER_OF_BYTES_USED) AS MEMORY_BYTES
FROM performance_schema.memory_summary_by_thread_by_event_name
GROUP BY THREAD_ID
ORDER BY MEMORY_BYTES DESC
LIMIT 10;
Этот запрос помогает определить потоки с заметным объёмом учтённых выделений памяти MySQL.
Но это не полная оценка RAM, используемой сервером: некоторые выделения могут не учитываться инструментами Performance Schema. Память самого процесса MySQL и внешних обработчиков нужно контролировать средствами операционной системы или системы мониторинга.
Для задач индексации полезно собирать как минимум продолжительность задания, его статус, объём обработанных данных и пиковое потребление памяти. Если показатели выходят за установленные границы — формировать предупреждение.
5. Защитите обработчик от повторного запуска
Перед запуском нового задания стоит проверять, не выполняется ли предыдущее.
Один из вариантов для приложений, использующих MySQL, — именованная блокировка GET_LOCK().
SELECT GET_LOCK('catalog_reindex', 0)
    AS lock_acquired;
Если результат равен 1, блокировка получена. Если 0 — она уже занята и ожидание завершилось. NULL означает ошибку.
После получения блокировки приложение выполняет индексацию, а при завершении освобождает её:
SELECT RELEASE_LOCK('catalog_reindex')
    AS lock_released;
Здесь есть важное условие: блокировка связана с соединением MySQL, а не с транзакцией. Соединение нужно сохранять открытым на всё время индексации, а освобождение блокировки выполнять в гарантированном блоке завершения обработки.
Также необходимо предусмотреть таймаут задания и корректную обработку ошибок. Если обработчик работает на нескольких серверах, механизм блокировки должен быть общим для всех экземпляров.
И ещё одна деталь: если блокировка занята, новый запрос на индексацию нельзя просто отбросить — ведь очередная синхронизация уже изменила данные. Изменённые записи нужно зафиксировать (например, в очереди или таблице «грязных» идентификаторов) и обработать следующим запуском. Иначе защита от перегрузки обернётся неактуальным поиском и фильтрами в каталоге.
Чего делать не стоит
Не пытайтесь решить всё добавлением RAM. Если обработчик без необходимости переиндексирует каталог целиком, увеличение памяти только повышает запас ресурсов. Ошибка в логике остаётся.
Не запускайте обновление кеша одновременно с тяжёлой индексацией без оценки нагрузки. Две ресурсоёмкие операции могут конкурировать за память, процессор и дисковый ввод-вывод. Их выполнение лучше согласовать.
Не связывайте локальное изменение с массовым пересчётом без необходимости. Обновление одной записи в таблице остатков не должно каскадом вызывать обработку всех товаров. Связанные изменения лучше собирать и выполнять контролируемыми пакетами.
Не игнорируйте повторные запуски. Если предыдущая загрузка или индексация ещё выполняется, новому заданию нужно либо дождаться своей очереди, либо корректно объединиться с уже запланированной обработкой.
Не ограничивайтесь формулировкой «база работает медленно». Снимайте показатели времени выполнения, CPU, оперативной памяти, количества обработанных записей и числа одновременно активных заданий.
Без измерений сложно определить реальную причину и проверить эффект оптимизации.
Итог: сначала разобраться в логике, потом масштабировать сервер
История с переиндексацией показала, что высокая нагрузка MySQL не всегда означает нехватку оборудования.
В нашем случае после обновления остатков система запускала цепочку операций, которая приводила к переиндексации практически всего каталога и потреблению до 10 ГиБ памяти. Повторные запуски дополнительно усиливали проблему.
Мы изменили последовательность обновлений, убрали лишние сохранения, ограничили индексацию изменёнными данными и добавили мониторинг.
При подобных проблемах лучше начинать с анализа обмена и запросов, а не с покупки дополнительной оперативной памяти.
Если после обмена с 1С, ERP или складской системой ваш интернет-магазин надолго зависает, перегружает MySQL или запускает повторные обработки каталога, команда NJ Soft поможет провести аудит производительности, найти причину и доработать механизм синхронизации — подробнее в разделе «Поддержка и развитие».